
Qwen 3.8 Flash Next kini resmi menjadi senjata andal Alibaba dalam menanggapi perang harga yang kian sengit di industri kecerdasan buatan (AI) antara penyedia teknologi Tiongkok dan Amerika Serikat.
Diluncurkan secara global pada Kamis (27/8/2026), varian terbaru ini hadir bukan hanya untuk meramaikan pasar LLM (Large Language Model). Model ini dirancang khusus untuk membantu perusahaan yang menginginkan asisten virtual dan agen otomatis cerdas, tetapi terkendala biaya komputasi yang mahal.
Sebagai pratinjau awal dari arsitektur generasi keempat (Qwen 4) yang akan datang, model multimodal ini menawarkan terobosan rekayasa yang sangat khas.
Alih-alih membakar memori perangkat keras secara boros, arsitekturnya dimodifikasi agar dapat berjalan dengan sangat ringan, sehingga menjadikannya salah satu pilihan paling tangguh bagi pesaing di kategori kecerdasan buatan berlisensi terbuka (open weight).
Lalu, bagaimana trik efisiensi silikon yang ditawarkan Alibaba dan bagaimana performanya saat bersaing dengan model raksasa lainnya?
Arsitektur Pakar dan Manipulasi RAM
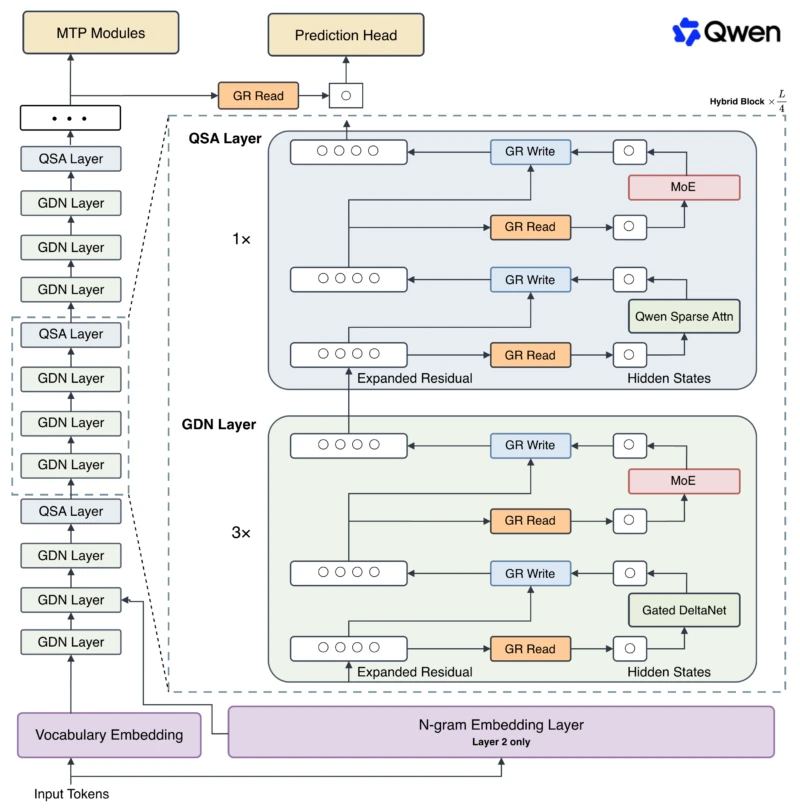
Inti dari efisiensi ekstrem model ini adalah penggunaan arsitektur Mixture-of-Experts (MoE). Secara teoritis, sistem ini memiliki kapasitas besar mencapai 125 miliar parameter.
Namun berkat sistem MoE, hanya sekitar 6 miliar parameter yang aktif saat mesin memproses setiap token. Hal ini sangat berbeda dengan “versi kakaknya”, Qwen 3.8 Max, yang membawa beban penuh 2,4 triliun parameter setiap saat.
Inovasi rekayasa paling revolusioner lainnya adalah penyisipan lapisan N-gram embedding yang menyimpan 51 miliar parameter. Lapisan ini berperan sebagai “kamus” pintar yang menyimpan kumpulan kata yang paling sering digunakan oleh manusia.
Sangat menarik, basis data kamus raksasa ini bisa disimpan sepenuhnya di dalam memori sementara (RAM) komputer, tanpa perlu disuntikkan ke dalam memori kartu grafis (VRAM) GPU yang sangat mahal.
Dominasi Benchmark dan Pekerjaan Profesional
Pengurangan biaya komputasi yang signifikan ternyata tidak mengorbankan kecerdasannya. Model ini dirancang khusus untuk menaklukkan skenario penggunaan tingkat perusahaan, seperti mengoperasikan agen AI, berinteraksi dengan API yang kompleks, mengakses basis data eksternal, hingga menggunakan kalkulator digital melalui perintah teks maupun visual.
Alibaba bahkan mengklaim bahwa biaya pelatihan dan inferensi model ini sembilan kali lebih murah dibandingkan dengan Qwen 3.7-Plus. Meski hemat biaya, kemampuannya dalam menyelesaikan struktur pemrograman (coding) justru meningkat drastis.
Berdasarkan pengujian teknis yang dipublikasikan secara resmi, model ini meraih skor 58,7 pada DeepSWE dan 62,5 pada SWE-bench Pro—dua tolak ukur standar industri untuk menguji kemampuan AI dalam mendeteksi dan memperbaiki celah bug pada proyek software.
Ketajamannya dalam menangani tugas perkantoran juga tidak bisa diabaikan. Pada platform CoWorkBench, model ini mencatat skor mengesankan 73,9, jauh meninggalkan DeepSeek-V4-Flash yang hanya mencapai 45,1.
Sementara pada pengujian JobBench yang mensimulasikan alur kerja profesional, skornya mencapai 55,7, naik hampir dua kali lipat dibandingkan dengan Qwen 3.7-Plus. Dalam berbagai parameter tersebut, kemampuan sistem ini secara konsisten mengungguli model-model elit lainnya, termasuk Claude Opus 4.6 dari Anthropic.
Penurunan Harga Ekstrem di Pasar Terbuka
Untuk mempercepat adopsi massal, Alibaba menetapkan harga sewa yang pasti membuat pesaingnya khawatir. Akses ke model ini hanya berharga 0,16 dolar AS (sekitar Rp 2.838) per 1 juta token input, dan 0,47 dolar AS (sekitar Rp 8.337) per 1 juta token output.
Angka ini sangat jauh berbeda jika dibandingkan dengan tarif Qwen 3.8 Max yang mencapai 2 dolar AS untuk input dan 6 dolar AS untuk output.
Tidak hanya murah, status model ini adalah open weight, sangat berbeda dengan sistem tertutup (proprietary) yang diterapkan oleh OpenAI. Berkas lengkapnya dapat diunduh secara gratis oleh komunitas pengembang melalui repositori Hugging Face dan ModelScope.
Menurut analis senior Gartner, Arun Chandrasekaran, kombinasi status transparan dan efisiensi inferensi yang tinggi inilah yang memungkinkan biaya komputasinya ditekan hingga titik terendah.
Persaingan ekosistem kecerdasan buatan berbiaya rendah ini jelas membuka peluang inovasi yang tak terbatas bagi perusahaan rintisan maupun pengembang independen.
Untuk terus memantau rilis terbaru dari platform Hugging Face, perbandingan akurasi benchmark AI global, hingga berita peluncuran perangkat keras pendukung produktivitas, pastikan untuk selalu membaca artikel mendalam lainnya hanya di TheCuy Tekno.
FAQ
1. Bagaimana Qwen 3.8 Flash Next berbeda dengan model AI lainnya?
Ini adalah model AI berbasis Mixture-of-Experts (MoE) yang dirancang untuk mencapai efisiensi ekstrem. Meski memiliki 125 miliar parameter, sistem ini hanya mengaktifkan sekitar 6 miliar parameter saat memproses perintah, sehingga jauh lebih cepat dan hemat saat digunakan.
2. Berapa biaya operasional model AI ini?
Alibaba menetapkan tarif yang sangat kompetitif, yaitu hanya 0,16 dolar AS untuk setiap 1 juta token input dan 0,47 dolar AS untuk setiap 1 juta token output, menjadikannya sangat terjangkau bagi perusahaan rintisan.
3. Di mana pengembang dapat memperoleh berkas model ini?
Sebagai sistem berlisensi open weight, seluruh berkas dan bobot hasil pelatihan dari model terbaru Alibaba ini tersedia secara cuma-cuma di repositori terbuka seperti Hugging Face dan ModelScope.
4. Apakah model yang terjangkau ini dapat digunakan untuk coding?
Sangat mampu. Meski dirancang hemat biaya, model ini justru meraih skor sangat tinggi pada pengujian standar industri perangkat lunak seperti DeepSWE dan SWE-bench Pro, bahkan diklaim mampu mengungguli pesaing kelas atas seperti Claude Opus 4.6 dalam tugas perkantoran.
terimakasih sudah mengunjungi thecuy. 🙂

Penulis Berpengalaman 5 tahun.